共分散の求め方を完全解説!公式の意味からエクセル計算まで一挙網羅
データ分析や統計検定の勉強を進める中で、多くの人が最初にぶつかる壁が「共分散の求め方」です。数式を見ると複雑な記号が並び、手計算の手順やエクセルでの算出方法に戸惑う声も少なくありません。しかし、その本質を紐解けば、共分散は「2つのデータの連動性」を数値化する極めてシンプルな指標です。
2026年現在、ビジネス現場でのデータドリブンな意思決定やAIツールの普及に伴い、統計学の基礎リテラシーとして共分散を正しく理解する重要性は一段と高まっています。本稿では、共分散の公式の意味から初心者でも迷わない手計算のステップ、エクセル関数の実践的な使い分け、相関係数との本質的な違いまで、現場目線で徹底的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:共分散は「Xが増えたときにYも増えるか」という2変数の直線的な増減の向きを示す基礎指標。
- 要点2:計算は「各データの偏差の積を合計(偏差積和)してデータ数で割る」手順で誰でも手計算が可能。
- 要点3:値の大きさは測定単位に依存するため、連動の強さを純粋に測るには「相関係数」への標準化が不可欠。
【基礎から図解】共分散とは何か?直感的にわかる仕組みと公式の意味
統計学の基礎において、共分散(Covariance)は「2つの確率変数がどのように連動して変化するか」を数値化したものです。例えば「気温とアイスクリームの売上」や「勉強時間とテストの点数」のように、一方が動いたときにもう一方がどう反応するかを捉えます。
直感的な理解を助けるために、共分散の符号が持つ意味を整理します。
- 正の値(プラス):一方が平均より大きいとき、もう一方も平均より大きくなりやすい(右上がりの傾向・正の相関)。
- 共分散が負の値(マイナス)の意味:一方が平均より大きいとき、もう一方は平均より小さくなりやすい(右下がりの傾向・負の相関)。
- ゼロ付近:2つのデータの増減に直線的な関連性が見られない(無相関)。
共分散の基本公式は以下の通りです。データ $X$ と $Y$ のそれぞれの平均値を $\bar{X}, \bar{Y}$、データ数を $n$ としたとき、次のように定義されます。
$$\operatorname{Cov}(X, Y) = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{X})(y_i - \bar{Y})$$
この式が意味しているのは、「Xの偏差(平均からのズレ)とYの偏差を掛け合わせ、その総和を全体の個数で割った平均値」です。両方がプラス、または両方がマイナスであれば積はプラスになり、片方だけがマイナスなら積はマイナスになります。この「掛け算の平均」こそが共分散の正体です。
【実践ステップ】5分で解ける共分散の求め方|手計算の具体例と偏差積和
共分散の計算でつまずかないための最も確実なアプローチは、「偏差積和」を経由するステップごとの手計算です。以下の5人の生徒の「数学の勉強時間(時間)」と「テストの点数(点)」のデータを使って、実際に計算手順を追っていきます。
【サンプルデータ】
A君:(2時間, 50点)
B君:(4時間, 60点)
C君:(6時間, 70点)
D君:(8時間, 70点)
E君:(10時間, 100点)
ステップ1:それぞれの平均値を算出する
勉強時間 $X$ の平均値 $\bar{X} = (2 + 4 + 6 + 8 + 10) \div 5 = 6$ 時間
テスト点数 $Y$ の平均値 $\bar{Y} = (50 + 60 + 70 + 70 + 100) \div 5 = 70$ 点
ステップ2:各データの偏差(平均との差)を出す
・A君:$X$の偏差は $2 - 6 = -4$、$Y$の偏差は $50 - 70 = -20$
・B君:$X$の偏差は $4 - 6 = -2$、$Y$の偏差は $60 - 70 = -10$
・C君:$X$の偏差は $6 - 6 = 0$、$Y$の偏差は $70 - 70 = 0$
・D君:$X$の偏差は $8 - 6 = +2$、$Y$の偏差は $70 - 70 = 0$
・E君:$X$の偏差は $10 - 6 = +4$、$Y$の偏差は $100 - 70 = +30$
ステップ3:偏差の積を計算し、合計する(偏差積和の求め方)
・A君:$(-4) \times (-20) = 80$
・B君:$(-2) \times (-10) = 20$
・C君:$0 \times 0 = 0$
・D君:$(+2) \times 0 = 0$
・E君:$(+4) \times (+30) = 120$
これらをすべて足し合わせた値が偏差積和となります。
偏差積和 $= 80 + 20 + 0 + 0 + 120 = \mathbf{220}$
ステップ4:データ数(または $n-1$)で割る
集団全体(母集団)として計算する場合、偏差積和をデータ数 $n = 5$ で割ります。
共分散 $= 220 \div 5 = \mathbf{44}$
手計算のステップを踏めば、数式の複雑さに惑わされることなく正確な値を導き出せます。
【徹底比較】共分散と相関係数の決定的な違い|なぜ単位が問題になるのか
共分散を学ぶ上で最も多くの人が疑問に抱くのが、「共分散と相関係数は何が違うのか?」という点です。結論から言えば、「単位の有無」と「関係の強さを比較できるかどうか」が決定的な違いです。
共分散の最大の弱点は、元のデータの単位を掛け合わせた単位を持ってしまうことです。例えば、身長(cm)と体重(kg)の共分散は「$\text{cm} \cdot \text{kg}$」という実体のない単位になります。身長をメートル(m)に変えて計算すると、データの連動関係は全く同じであるにもかかわらず、共分散の数値自体は100分の1に縮んでしまいます。
| 比較項目 | 共分散(Covariance) | 相関係数(Correlation Coefficient) | 編集部の見解・実務上の評価 |
|---|---|---|---|
| 役割・目的 | 2変数の増減の方向性を把握する | 2変数の直線的な関連の強さを測る | 強弱を議論するなら相関係数が必須 |
| 値の範囲 | $-\infty$ から $+\infty$(制限なし) | $-1.0$ から $+1.0$(正規化済み) | 相関係数は一目で関係性の強さが判明 |
| 単位(ディメンション) | あり(2変数の単位の積) | なし(無次元数) | 共分散は単位換算で数値が変わる点に注意 |
| 計算式の関係 | 偏差積和 $\div$ データ数 | 共分散 $\div$ (Xの標準偏差 $\times$ Yの標準偏差) | 相関係数は「共分散の単位を打ち消した値」 |
共分散をそれぞれの標準偏差で割ることで、単位の影響を取り除き、常に $-1$ から $+1$ の間に収まるようにした指標がピアソンの積率相関係数です。「向きを知りたいときは共分散、強さを比較したいときは相関係数」と使い分けましょう。
【エクセル活用術】COVARIANCE.S関数の使い方と標本・母共分散の罠
実務で共分散を求める場合、表計算ソフトの活用が主流です。エクセル計算では、分析の前提条件に応じて2つの関数を厳密に使い分ける必要があります。
1. 母共分散を求める:COVARIANCE.P 関数
集めたデータそのものが調査対象の全体(全数調査)である場合に使用します。分母をデータ数 $n$ で割る計算を行います。
=COVARIANCE.P(配列1, 配列2)
2. 標本共分散を求める:COVARIANCE.S 関数
集めたデータが一部のサンプル(標本調査)であり、背後にある母集団の共分散を偏りなく推定(不偏推測)したい場合に使用します。分母を自由度である $n-1$ で割る計算を行います。
=COVARIANCE.S(配列1, 配列2)
実務のマーケティング分析やアンケート調査では、全数ではなくサンプルデータを扱うケースがほとんどであるため、基本的には「COVARIANCE.S」を選択するのが鉄則です。旧バージョンの互換性関数である COVAR は母共分散($n$ で割る)を返す仕様になっているため、意図しない計算ミスを防ぐためにも新しい関数の使用が推奨されます。
【実態検証】データ分析で多くの人が陥る「共分散の誤解と盲点」
実務現場や資格試験の受験者コミュニティを調査すると、共分散に関して共通する「3大トラップ」が存在することが浮き彫りになります。
落とし穴1:「共分散の数値が大きい=相関が強い」という錯覚
「共分散が5000もあるから、この2つのデータには強い関係がある」と判断するのは典型的な誤りです。例えば、通貨単位を「円」から「千円」に変えるだけで、共分散は大きく変動します。数値の絶対的な大きさに意味はなく、強弱の判定には必ず相関係数を用いなければなりません。
落とし穴2:外れ値(異常値)による極端な歪み
共分散は平均値からの差を2乗に近い形で掛け合わせるため、たった1つの極端な外れ値によって正負が逆転したり、数値が何倍にも跳ね上がったりする脆弱性を持っています。データを投入する前に散布図を描き、外れ値の有無を目視確認するステップを怠ってはいけません。
落とし穴3:非線形な関係を捉えられない
共分散が検出できるのは「直線的な関係」のみです。例えば、$Y = X^2$ のような綺麗なU字型の関係(放課後の気温とエアコン稼働率など)が存在していても、共分散を計算するとゼロ近くになり、「関連なし」と誤認してしまうリスクがあります。
【プロの結論】どの指標を使うべきか?判断の基準
・共分散をそのまま使うべきケース:ポートフォリオ理論による金融資産の分散投資リスク計算、多変量解析、共分散構造分析など、後続の高度な統計数理モデルに入力する場合。
・相関係数を使うべきケース:2つの指標の関連性をレポートで報告したり、施策の因果関係を探索したりする一般的なビジネス分析全般。
【発展編】多変量解析を支える「共分散行列の求め方」と実務での活用
3つ以上の変数を扱う多変量解析(主成分分析や重回帰分析など)では、個別の共分散ではなく「共分散行列(分散共分散行列)」が頻繁に用いられます。
例えば、$X_1, X_2, X_3$ という3つの変数がある場合、共分散行列は以下のような $3 \times 3$ の正方行列になります。
$$\Sigma = \begin{pmatrix} \operatorname{Var}(X_1) & \operatorname{Cov}(X_1, X_2) & \operatorname{Cov}(X_1, X_3) \\ \operatorname{Cov}(X_2, X_1) & \operatorname{Var}(X_2) & \operatorname{Cov}(X_2, X_3) \\ \operatorname{Cov}(X_3, X_1) & \operatorname{Cov}(X_3, X_2) & \operatorname{Var}(X_3) \end{pmatrix}$$
対角成分(左上から右下への斜めのライン)には各変数の「分散」が並び、非対角成分には変数同士の「共分散」が並びます。$\operatorname{Cov}(X_1, X_2) = \operatorname{Cov}(X_2, X_1)$ であるため、共分散行列は常に対称行列となります。
エクセルの「データ分析」アドインにある「共分散」機能を使えば、複数列のデータを選択するだけで一括して共分散行列を出力できます。金融工学における複数銘柄のポートフォリオ最適化や、機械学習の前処理において極めて重要な役割を果たしています。
【共分散の求め方】に関するよくある質問(FAQ)
Q1:共分散を手計算するとき、母共分散($n$ で割る)と標本共分散($n-1$ で割る)のどちらを使うべきですか?
A1:学校の基礎的な試験問題で特に指定がない場合は、シンプルにデータ数 $n$ で割る母共分散の定義が一般的です。一方、大学レベルの統計学や実務のサンプル調査では、不偏推定量として $n-1$ で割る標本共分散が標準となります。問題文の前提条件を必ず確認してください。
Q2:共分散がマイナスの値になったのですが、計算間違いでしょうか?
A2:間違いではありません。共分散が負の値になるのは、「一方が増えると、もう一方が減る」という負の相関関係があることを意味します。例えば「標高と気温」や「価格と販売数量」などでは、共分散がマイナスになるのが正常です。
Q3:共分散の公式に「Xの2乗の平均」を使った簡単な別表現はありますか?
A3:あります。共分散は「積の平均 $-$ 平均の積」という簡便公式でも求められます。数式では $\operatorname{Cov}(X, Y) = \overline{XY} - \bar{X}\bar{Y}$ と表され、偏差を1つずつ引く手間を省いて高速に手計算したい場合に役立ちます。
まとめ:共分散を正しく使いこなしてデータの本質を見抜く判断基準
共分散は、一見すると難解な数式に見えますが、「偏差を掛けて平均する」という計算ステップさえ掴めば決して怖いものではありません。データの増減の向きを把握する基礎指標であり、相関係数や共分散行列へと発展する統計学の強固な土台です。
実務においては、共分散の数値そのもので強弱を早合点せず、測定単位の影響を排除した相関係数や散布図とセットで多角的に検証することが失敗を防ぐ鉄則です。手計算の流れとエクセル関数(COVARIANCE.S)を状況に応じて使いこなし、データが語る真の関連性を正確に読み解いていきましょう。 (出典: 共 分散 求め 方(Yahoo!ニュース))


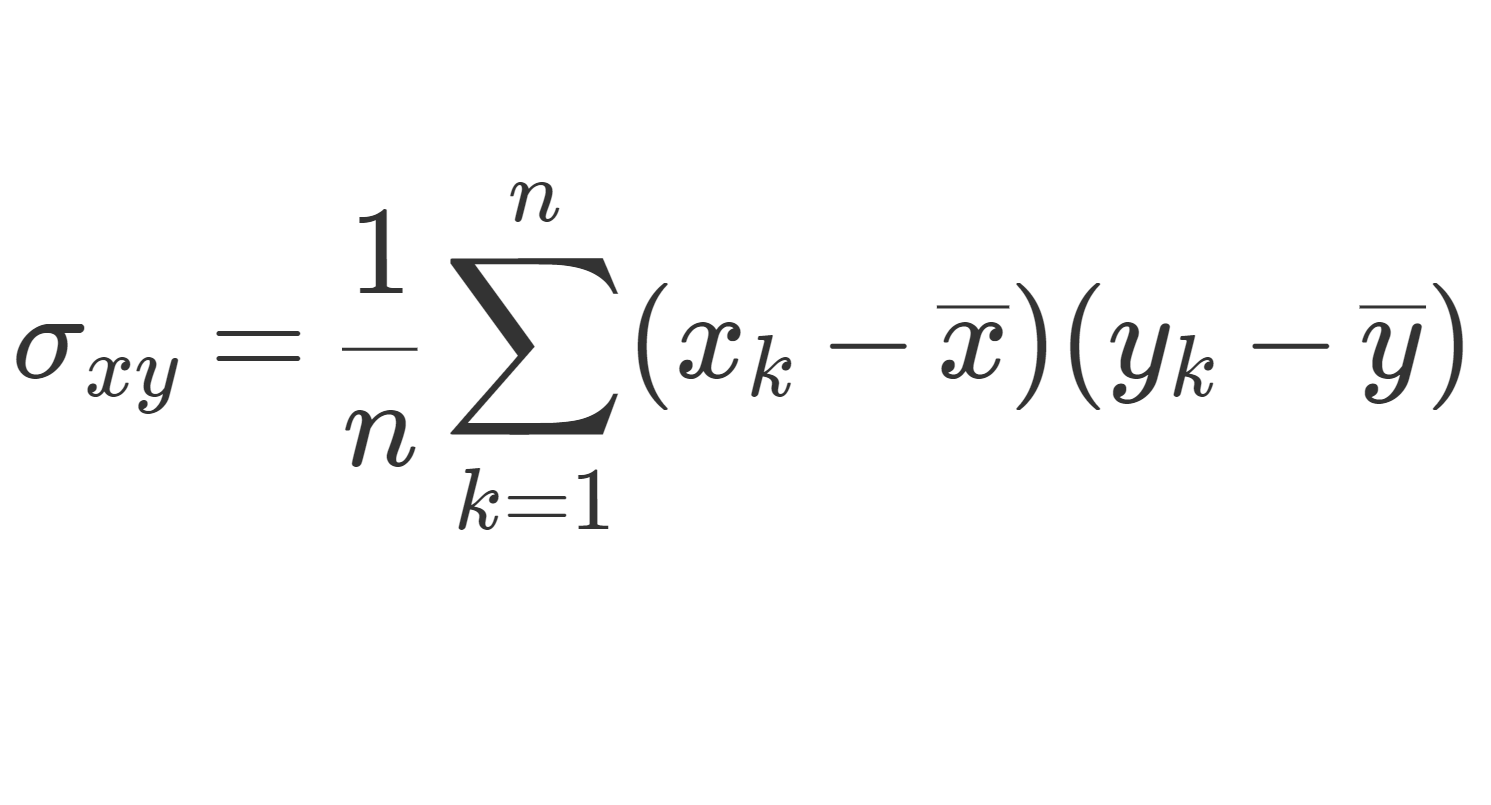
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
