2x2分割表の定義 [[a, B], [c, D]]
医学研究の臨床データやマーケティングのABテストなど、2群間の比率の差を検証する場面で「どの検定手法を選ぶべきか」は分析の信頼性を左右する重大な分岐点です。度数データを扱う代表格といえばピアソンのカイ二乗検定ですが、サンプルサイズが小さい場合にそのまま適用すると、理論上の近似が破綻して誤った結論を導く危険があります。
小標本データにおいて確固たる威力を発揮するのがフィッシャーの正確確率検定(フィッシャーの直接確率検定)です。本稿では、カイ二乗検定との使い分け基準や計算の仕組み、主要な統計ツール(R・Python・EZR・SPSS)での具体的な実行手順まで、現場で役立つ実践知を分かりやすく解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:期待度数が5未満のセルが全体の20%を超えるような小サンプルデータでは、カイ二乗検定ではなくフィッシャーの正確確率検定を選択するのが鉄則。
- 要点2:超幾何分布に基づいて「その分割表(およびそれ以上に極端な配置)が得られる確率」を直接算出するため、近似誤差が生じない。
- 要点3:RやPython(SciPy)、EZR、SPSSなどの主要解析環境に標準搭載されており、2×2分割表であれば数行のコードや簡単なクリック操作で即座に実行可能。
【使い分けの真相】フィッシャーの正確確率検定を使うべき決定的な場面
分割表を用いた独立性の検定において、フィッシャーの検定とカイ二乗検定のどちらを選ぶべきかという議論は、統計解析の初歩でありながら現場で最も頻出する疑問の一つです。判断の分かれ目となるのは、収集できたサンプルサイズと各セルの期待度数にあります。
ピアソンのカイ二乗検定は、中心極限定理を前提とした「漸近的(近似的)手法」です。標本数が十分に大きければ高い精度を誇りますが、データ数が少ないと近似の精度が急激に低下します。具体的には、いわゆる「コクランの基準」として知られる「期待度数が5未満のセルが全体の20%以上を占める場合」や「最小期待度数が1未満のセルが存在する場合」には、カイ二乗検定の適用を避けなければなりません。
稀少疾患の症例対照研究や小規模なユーザー調査のように、全体の観測数が数十例程度にとどまるケースでは、期待度数が容易に5を下回ります。こうした極小標本下でも近似に頼らず厳密な確率を計算できる点が、フィッシャーの正確確率検定を採用すべき決定的な理由です。
【仕組みと数学的背景】2×2分割表における計算手順と超幾何分布
フィッシャーの正確確率検定が「正確(Exact)」と呼ばれる所以は、確率論の超幾何分布を利用して手元の分割表が生起する確率そのものをダイレクトに導き出す点にあります。
行と列の周辺合計(マージナル合計)を固定した前提に立つと、2×2分割表の各セル度数(a, b, c, d)が出現する確率は以下の公式で求められます。
P = {(a + b)! × (c + d)! × (a + c)! × (b + d)!} / {n! × a! × b! × c! × d!}
(※nは総サンプル数、!は階乗を表す)
実際の検定手順では、手元のデータから得られた分割表の生起確率を算出するだけでは終わりません。「手元のデータと同等、あるいはそれ以上に帰属仮説から離れた極端な分割表」の組み合わせをすべて洗い出し、それぞれの生起確率を合算することでp値を導き出します。
【数値の読み解き方】p値の解釈と「片側検定・両側検定」の選択基準
算出されたp値が有意水準(一般には5%=0.05)を下回った場合、「2つの要因の間には統計的に有意な関連がある(独立ではない)」と判定します。しかし、ここで初学者が陥りやすいのが片側検定と両側検定の選択を巡る混乱です。
新薬がプラセボより優れていることだけを検証したい場合など、事前の理論的背景から効果の方向性が一方向に限定されるケースでは「片側検定」が用いられることもあります。しかし、未知の要因を探索する分析や医学論文の標準的なプロトコルでは、方向性をあらかじめ仮定しない「両側検定」の採用が原則です。
両側検定のp値を求める際、フィッシャーの検定では「観測された表の生起確率以下の確率を持つ、反対側の極端な表」の確率を合計する手法が広く普及しています。統計ソフトによって両側p値の算出ロジックに細かな差異が存在する場合があるため、どの定義に基づいているかを把握しておくことも確かな論文執筆には欠かせません。
【実践・コード編】Python(SciPy)とR言語による実装コード
現代のデータ分析環境において、2×2分割表の手計算を強いられる場面はまずありません。代表的なプログラミング言語を使えば、わずか数行で正確確率検定を実行できます。
▼ Python(SciPyライブラリ)での実装例
import scipy.stats as stats table = [[8, 2], [1, 9]] # フィッシャーの正確確率検定(両側検定) oddsratio, p_value = stats.fisher_exact(table, alternative='two-sided') print(f"オッズ比: {oddsratio:.4f}") print(f"p値: {p_value:.4f}") ▼ R言語での実装例
# 2x2行列の作成 dat <- matrix(c(8, 1, 2, 9), nrow = 2, dimnames = list(Group = c("Exposed", "Unexposed"), Outcome = c("Positive", "Negative"))) # フィッシャーの正確確率検定 fisher.test(dat) R言語のfisher.test()関数は、p値のみならずオッズ比の95%信頼区間も同時に返してくれるため、臨床研究者にとって非常に扱いやすい設計となっています。
【GUIツール編】EZR・SPSSでの操作手順と出力結果の見方
プログラミングを伴わないGUIベースの統計ソフトを利用する医療従事者やマーケターにとっても、操作手順は極めて直感的です。
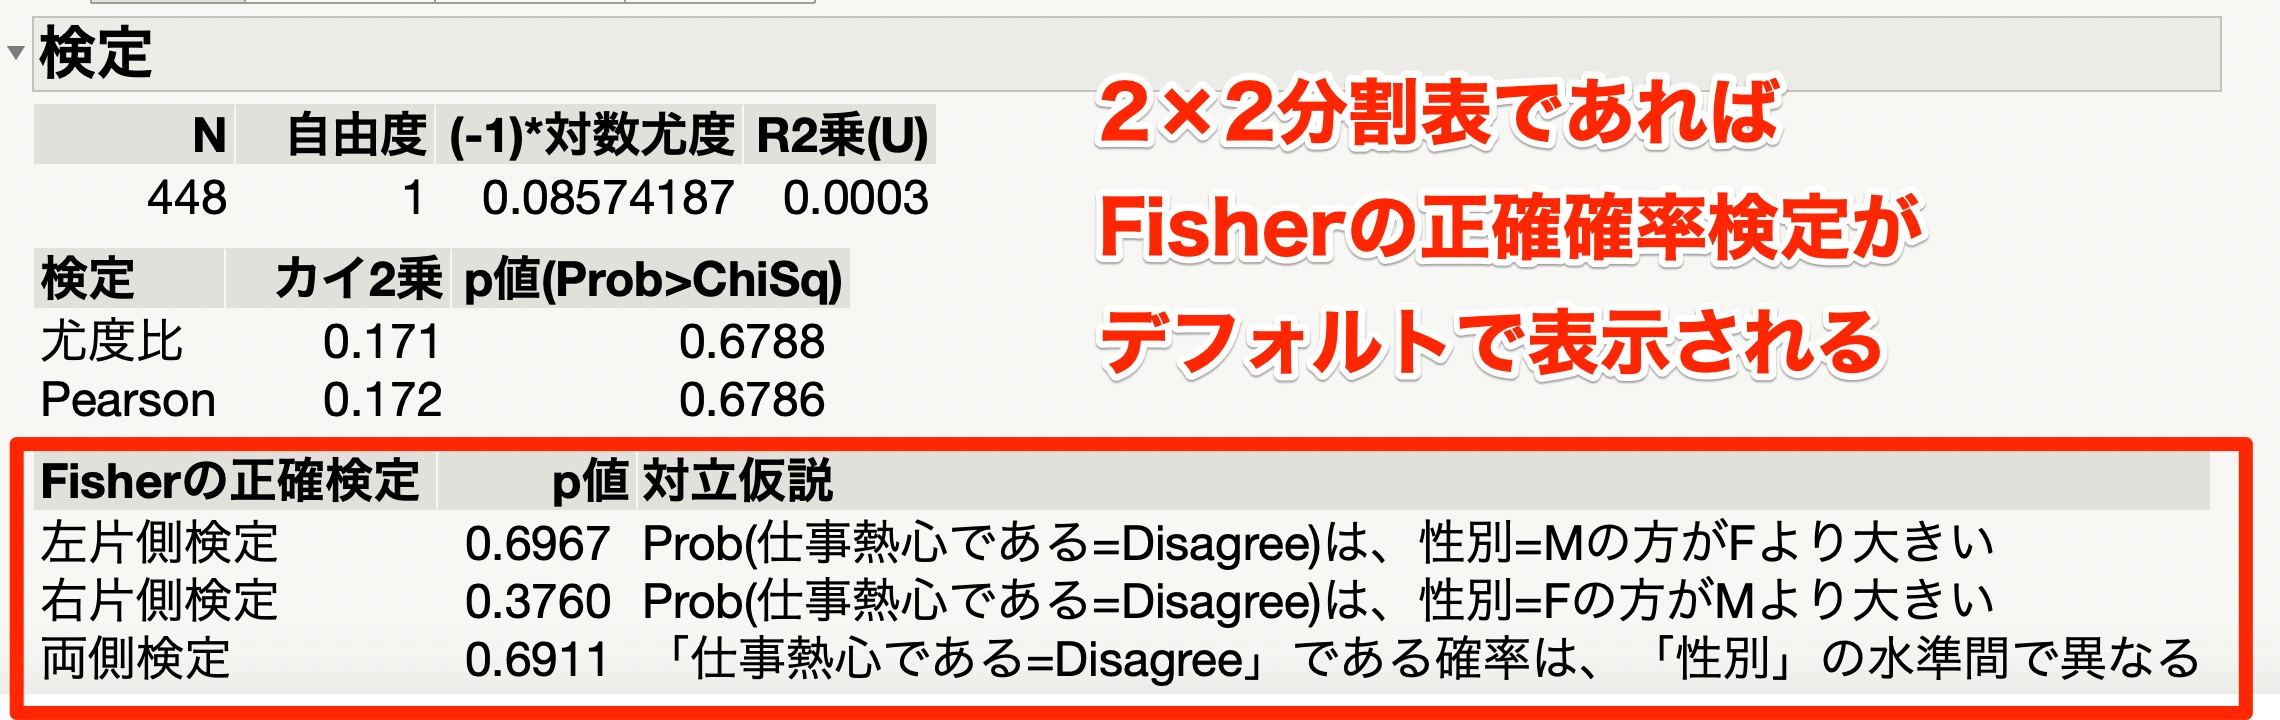
自治医科大学附属さいたま医療センターが開発したフリーの統計ソフトEZR(Easy R)では、メニューバーから「統計解析」→「名義変数の解析」→「2×2分割表の独立性の検定」を選択します。クロス集計表を作成するダイアログ内で「フィッシャーの正確検定」にチェックを入れるだけで、カイ二乗検定の結果と並んで正確確率検定のp値が出力されます。
商用ソフトの代表格であるSPSSでは、「分析」→「記述統計」→「クロス集計表」を開き、「統計」ボタンから「カイ二乗」にチェックを入れます。さらに「正確」ボタンをクリックして「正確」ラジオボタンを有効化することで、2×2表において自動的にフィッシャーの直接確率が出力ウィンドウに表示される仕様です。
【フィッシャーの正確確率検定】に関するよくある質問(FAQ)
Q1:3×3以上の大きな分割表(m×n分割表)でもフィッシャーの検定は使えますか?
A1:利用可能です。2×2分割表を超えると計算量が爆発的に増加するため「Freeman-Haltonの拡張法」と呼ばれるアルゴリズムが用いられます。R言語のfisher.test()やSPSSの正確検定オプションであれば、計算機パワーを活用して多分割表の正確確率を自動で計算できます。
Q2:サンプルサイズが十分に大きい場合でも、あえてフィッシャーの検定を使って良いですか?
A2:理論上は問題ありません。ただし、標本数が数千〜数万件に達すると階乗の組み合わせ計算負荷が極めて高くなり、ソフトの処理が停止または長時間化することがあります。大標本ではカイ二乗検定の結果とフィッシャーの検定結果は実質的に一致するため、大標本ならカイ二乗検定を選択するのが実務上合理的です。
Q3:イェーツの補正をかけたカイ二乗検定とフィッシャーの検定はどちらが推奨されますか?
A3:かつては計算機が非力だったためイェーツの連続性補正が重宝されましたが、補正カイ二乗検定は保守的になりすぎて第2種の過誤(差があるのに見落とす確率)が増加する欠点が指摘されています。現代の計算環境においては、小サンプルなら補正カイ二乗検定を挟まず、直接フィッシャーの正確確率検定を実施することが推奨されます。
まとめ:小サンプル解析で信頼性の高いエビデンスを導くために
データの規模が小さく、期待度数が5を下回るような過酷なデータ構造であっても、フィッシャーの正確確率検定を適切に用いれば、近似の歪みに惑わされることなく堅牢な結論を導き出せます。手法の前提条件とツールの正しい操作法を押さえ、エビデンスレベルの高いデータ分析を進めていきましょう。 (出典: フィッシャー の 正確 確率 検定(Yahoo!ニュース))


最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
